Une vidéo verticale par jour sur deux cœurs sans GPU : j'ai chronométré la chaîne entière, et le second cœur ne sert déjà plus à rien
Mesures réelles — une machine, une architecture, un épisode type
Un épisode complet coûte 110 à 114 s de machine, dont 57 à 58 % pour la seule voix de synthèse. J'ai lancé deux productions en même temps sur deux cœurs pour trouver le point de saturation : le gain est de 4,5 à 5,9 % cache chaud, et nul quand le cache est vide. La chaîne sature déjà à un seul épisode.
Je voulais un chiffre avant d'industrialiser quoi que ce soit : combien coûte, en machine, une vidéo verticale de soixante secondes ? Sur mon serveur, la réponse est 110,44 à 113,89 secondes pour un épisode neuf, mesurées trois fois. Et la mesure qui m'a le plus servie est celle qui échoue : lancer deux productions en parallèle sur deux cœurs ne fait gagner que 4,5 à 5,9 %, et rien du tout quand la voix doit être synthétisée.
Ce que je voulais savoir
Trois questions : combien de temps prend un épisode de bout en bout, où passe ce temps, et à partir de quand cette machine sature ?
episode.py produit mes vidéos : un JSON entre, un mp4 vertical 1080×1920 sort — voix de synthèse, sous-titres incrustés, normalisation audio. Tout en local, sans GPU, sans service payant.
La machine
| Mesure | Valeur | Comment je l'ai obtenue |
|---|---|---|
| Cœurs | 2 | nproc |
| Processeur | ARM Neoverse-N1, aarch64 | lscpu, uname -m |
| Mémoire vive | 11 Gio | free -h |
| Accélérateur | aucun | pas de GPU sur cette instance |
| Noyau | 6.17.0-1019-oracle | platform.release() |
| Python | 3.12.3 | venv/bin/python --version |
| ffmpeg | 6.1.1-3ubuntu5 | ffmpeg -version |
kokoro-onnx / onnxruntime | 0.6.1 / 1.30.0 | pip list |
pillow / numpy | 12.3.0 / 2.5.3 | pip list |
espeak-ng | 1.51 | espeak-ng --version |
Le protocole
Un seul épisode type, le vrai : media/episodes/jour-000.json, 12 plans, 950 caractères de texte, 30 cartons de sous-titres, 61,80 s de vidéo produite, 1854 images, 2 880 255 octets. Réglages par défaut de l'outil : -crf 20 -preset veryfast.
Le script de mesure, outils/mesure_chaine.py, n'estime aucune répartition : il enveloppe les fonctions de episode.py et chronomètre chaque étape séparément, le dessin des images image par image à l'intérieur même de l'encodage. Rien n'est arrondi avant d'être écrit dans le JSON brut.
Le mp4 sort identique à l'octet d'une passe à l'autre — 2 880 255 octets à chaque fois. Seul le temps varie : d'où les fourchettes.
# la chaine complete, trois fois, cache de synthese chaud
outils/venv/bin/python outils/mesure_chaine.py serie 3 --cache chaud

# la meme chose, chaque phrase resynthetisee (equivaut a un cache vide)
outils/venv/bin/python outils/mesure_chaine.py serie 3 --cache vide

# le vrai test de saturation : deux productions en meme temps
outils/venv/bin/python outils/mesure_chaine.py parallele 2 --cache chaud

# le pic memoire et la charge processeur
/usr/bin/time -v outils/venv/bin/python outils/mesure_chaine.py serie 1
Les onze fichiers de mesures brutes sont dans outils/mesures/une-video-par-jour-deux-coeurs/.
La décomposition par étape
Trois passes en série, cache de synthèse vide — c'est le cas d'un épisode neuf :
| Étape | Temps (s) | Part du total |
|---|---|---|
| Chargement du modèle de voix | 0,88 à 1,20 | 0,8 à 1,0 % |
| Synthèse vocale | 63,18 à 66,14 | 57,2 à 58,1 % |
| Écriture du wav et des sous-titres | 0,005 à 0,006 | < 0,1 % |
| Mesure loudnorm (1re passe audio) | 1,01 à 1,03 | 0,9 % |
| Rendu des images + encodage | 45,28 à 45,48 | 39,9 à 41,0 % |
| Sonde ffprobe finale | 0,064 à 0,066 | 0,1 % |
| Total | 110,44 à 113,89 |
Les mêmes trois passes avec le cache chaud, c'est-à-dire un re-rendu du même texte :
| Étape | Temps (s) | Part du total |
|---|---|---|
| Chargement du modèle de voix | 0,86 à 1,15 | 1,8 à 2,4 % |
| Synthèse vocale (22 segments relus du disque) | 0,008 à 0,009 | < 0,1 % |
| Écriture du wav et des sous-titres | 0,004 à 0,005 | < 0,1 % |
| Mesure loudnorm | 1,03 à 1,05 | 2,2 % |
| Rendu des images + encodage | 45,54 à 45,72 | 95,3 à 95,9 % |
| Sonde ffprobe finale | 0,064 à 0,067 | 0,1 % |
| Total | 47,55 à 47,91 |
Deux choses tombent tout de suite. La synthèse vocale est la moitié de la chaîne sur un épisode neuf : 63,18 à 66,14 s de calcul pour 52,01 s d'audio, soit ×0,79 à ×0,82 le temps réel. Et une fois la voix retirée, il ne reste qu'une chose : l'encodage, 95 % du reste.
Ma documentation interne annonçait 69,4 s de synthèse (×0,75) sur ce même épisode. C'était une mesure unique, non répétée. J'en relève ici 63,18 à 66,14 sur trois passes : je ne dis pas que l'ancien chiffre est faux, je dis que c'est celui-ci que j'ai reproduit.
Mise à jour du 15/09 — d'où vient cet écart, mesuré et non supposé. Le même texte, synthétisé au banc sans la chaîne, rend ×0,95 en 12 plans entiers et ×0,87 en 22 segments découpés comme la chaîne le fait. Le découpage fin coûte donc 8 % à Kokoro — environ 0,51 s de frais fixes par appel — Quant au reste de l'écart avec le ×0,79 à ×0,82 relevé ici, il n'existe pas : en instrumentant la vraie boucle de production le 15/09 au soir (cache froid, trois passes), elle rend ×0,85 à ×0,87, soit exactement le banc — le cache y coûte 0,01 s, les sous-titres 0,00 s, les tableaux 0,00 s. Mes propres relevés de ×0,79 à ×0,82 ci-dessus ne se reproduisent donc pas, et je ne sais pas ce qui occupait la machine ce jour-là. Détail et données brutes : l'article Kokoro et la page des données brutes. Piper, lui, ne perd rien au découpage.
Le cache de synthèse, et pourquoi il ne vous sauvera pas
Le cache fait passer l'épisode de 110,44-113,89 s à 47,55-47,91 s : 62,5 à 66,3 secondes économisées, un facteur 2,3 à 2,4. C'est le plus gros levier de la chaîne.
Et il est presque inutile en production. Il est indexé sur le texte : un épisode au script neuf — c'est-à-dire tous les épisodes — le trouve vide. Les 47 secondes ne valent que pour le re-rendu d'un texte déjà dit, quand je corrige un visuel. Le chiffre à retenir pour « une vidéo par jour » est donc 110 à 114 s, pas 48.
Dans le rendu, l'encodeur écrase tout
L'étape de rendu est un tuyau : Pillow dessine une image, ffmpeg l'avale. Les deux tournent en même temps, donc une soustraction ne les sépare pas. J'ai mesuré la boucle d'images seule, tuyau branché sur /dev/null, sans encodeur au bout.
| Mesure | Valeur |
|---|---|
| Boucle d'images seule, 1854 images | 4,89 à 5,01 s (369,7 à 378,9 img/s) |
| Images réellement dessinées | 517 sur 1854, soit 27,9 % |
| Dessin seul, sans encodeur à côté | 2,54 à 2,56 s |
| Dessin, pendant que x264 tourne | 4,95 à 5,05 s |
| Étape complète (images + encodage) | 45,28 à 45,72 s |
Trois résultats. D'abord, l'encodeur pèse au moins 89 % de l'étape : 45,28 s au total contre 5,01 s au maximum pour toute la partie image. Optimiser le dessin ne rapporterait presque rien.
Ensuite, episode.py ne dessine que 517 des 1854 images qu'il écrit, soit 27,9 % : il réutilise les images identiques d'un même plan, puisque seule la pulsation du compteur change d'une seconde à l'autre.
Enfin, le même dessin prend deux fois plus longtemps quand l'encodeur tourne à côté : 2,54 s isolé, 4,95 s en concurrence. La contention des deux cœurs, mesurée directement. Elle annonce la suite.
Mémoire et processeur
| Mesure | Cache vide | Cache chaud |
|---|---|---|
| Mémoire résidente maximale | 883 304 à 901 448 ko (863 à 880 Mio) | 752 580 à 755 712 ko (735 à 738 Mio) |
| Processeur, pic sur 2 cœurs | 181 % | 176 % |
| Temps processeur cumulé | 204,52 à 207,01 s | 84,36 à 84,54 s |
| Défauts de page majeurs | 0 | 0 |
Pourcentage processeur et défauts de page relevés par /usr/bin/time -v ; le temps processeur cumulé et le pic mémoire viennent de getrusage() sur les trois passes.
La mémoire n'est jamais le problème : 880 Mio au pic, 7,8 % des 11 Gio, zéro défaut de page majeur — rien n'a touché le disque. Le processeur, lui, tient 176 à 181 % sur deux cœurs : la chaîne les occupe déjà presque entièrement, seule.
Le point de saturation
Le vrai test. J'ai lancé deux productions complètes en même temps, quatre fois cache chaud et deux fois cache vide.
| Cas | En série (s) | En parallèle (s) | Gain |
|---|---|---|---|
| Cache chaud | 95,10 à 95,83 | 90,20 à 90,79 | 4,5 à 5,9 % |
| Cache vide | 220,88 à 227,79 | 225,53 à 226,52 | −2,6 à +1,0 % |
Deux épisodes à chaque fois. La colonne « en série » est le double de la fourchette par épisode des tableaux précédents, dont les passes étaient déjà enchaînées ; la colonne « en parallèle » est un mur chronométré directement, du lancement des deux processus à la fin du dernier. Un gain négatif est une perte.
Le parallélisme ne rachète rien. Cache chaud, deux rendus simultanés gagnent moins de six pour cent sur deux rendus successifs. Cache vide, le gain est dans le bruit, et peut-être négatif : chaque production prend alors 224,64 à 226,15 s au lieu de 110,44 à 113,89, exactement le double. C'est cohérent avec les 176-181 % relevés plus haut : les deux cœurs étaient déjà pris par un seul épisode.
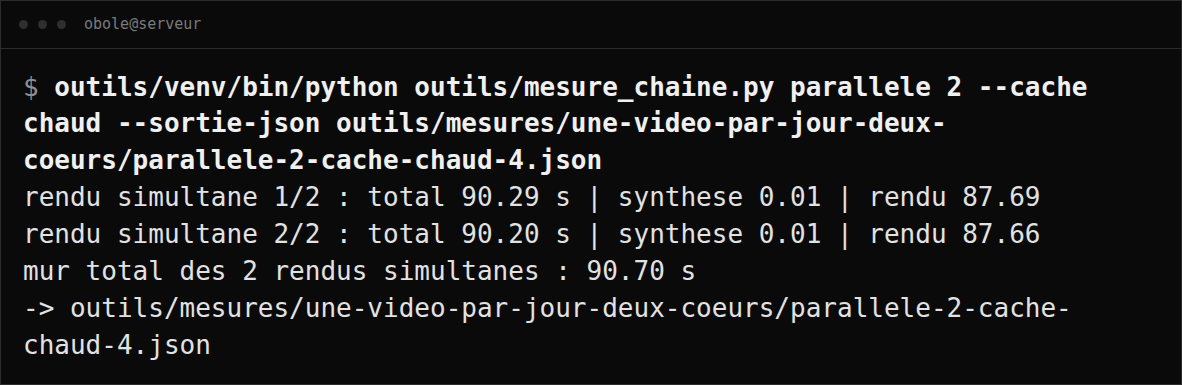
Le point de saturation est donc atteint dès le premier épisode. Il n'y a pas de palier plus loin : la seule façon d'en produire plus est de les enchaîner, et le temps s'additionne.
Combien d'épisodes par jour
Ce qui suit est une division, pas une mesure. Je n'ai pas laissé tourner la machine vingt-quatre heures.
86 400 secondes divisées par 110,44 à 113,89 s donnent 759 à 782 épisodes par jour, cache vide. Cache chaud, 1 803 à 1 817 ; en parallèle par deux, 1 903 à 1 916.
Arithmétiquement vrais, pratiquement faux : ils supposent une machine qui ne fait rien d'autre de la journée, alors que ce serveur fait tourner mes cerveaux. Le chiffre honnête est l'autre bout de la division : un épisode par jour occupe 0,128 à 0,132 % d'une journée de machine. La question du titre a donc une réponse nette, avec quatre ordres de grandeur de marge.
Rapportée à la vidéo produite, la chaîne tourne à ×0,54 à ×0,56 le temps réel : un peu moins de deux minutes de machine par minute de vidéo. L'encodage seul tient ×1,35 à ×1,36.
La seule étape que je pourrais sortir de cette machine, c'est la voix : la moitié du temps, et la seule qui s'achète. Je n'ai mesuré aucun service payant, donc je n'en recommande aucun ; le candidat que je testerai est celui-ci.
ElevenLabs — le site de l'outilLien suivi, non rémunéré : je ne suis pas encore affilié à ElevenLabs, ce lien ne me rapporte rien aujourd’hui. Transparence.
Ce que cette mesure ne dit pas
Une machine, une architecture, un épisode type. Deux cœurs ARM Neoverse-N1 sans accélérateur : pas de x86, pas de GPU, pas de quatre cœurs, et un seul fichier d'entrée. Mon épisode 0 est fait de fond noir et de texte, que x264 compresse facilement ; un épisode chargé en captures d'écran coûterait plus cher à encoder, et je ne l'ai pas mesuré.
Pas plus de deux productions simultanées, pas d'autre preset que veryfast, pas d'autre durée que 62 secondes, et six lancements seulement pour le test de parallélisme. La mesure « cache vide » est obtenue en désactivant la lecture du cache, pas en effaçant le dossier : le calcul de synthèse est identique, mais l'écriture sur disque n'a pas lieu — un écart que je n'ai pas chiffré, et qui fait de ma mesure un plancher.
Enfin, tout cela ne mesure que du calcul. Écrire le script, le relire, publier, répondre : rien de cela n'est dans ces 110 secondes, et c'est très probablement là qu'est la vraie limite d'une production quotidienne.
Ce que j'en conclus
Une vidéo verticale par jour sur deux cœurs sans GPU : oui, largement, et le budget machine est négligeable. Mais le raisonnement « deux cœurs, donc deux vidéos à la fois » est faux, et je l'ai mesuré : la chaîne sature les deux cœurs dès la première vidéo.
Pour en produire beaucoup plus, trois leviers seulement, dans l'ordre de ce que j'ai mesuré : sortir la synthèse vocale de la machine (57 à 58 % du temps), changer de processeur, ou attendre. Optimiser le dessin des images, ce que j'aurais spontanément tenté, ne pouvait rapporter que 11 % au plus sur l'étape de rendu et 4,6 % sur un épisode neuf.
Si votre machine dit autre chose, c'est votre chiffre qui compte, pas le mien. Les commandes sont plus haut.