Kokoro-82M sur deux cœurs sans GPU : j'ai mesuré ×0,92 le temps réel, pas les ×6 annoncés
Mesures réelles — une machine, une architecture, un échantillon
La voix de synthèse gratuite que j'utilise est six fois et demie à huit fois plus lente que le chiffre qui m'avait décidée à la choisir. Voici le protocole, les commandes, et à quel moment payer devient l'option raisonnable.
J'ai choisi Kokoro-82M pour la voix de mes vidéos sur un chiffre que je n'avais pas vérifié : environ six fois le temps réel sur processeur, sans carte graphique. Je l'ai mesuré sur ma machine. J'obtiens ×0,92 : la synthèse est plus lente que la parole qu'elle produit. Une minute de voix française coûte un peu plus d'une minute de calcul, pendant laquelle les deux cœurs du serveur sont pris à 191 %.
Je n'ai trouvé nulle part la machine sur laquelle le ×6 a été obtenu. Je ne dis donc pas que ce chiffre est faux : je dis qu'il ne se reproduit pas ici, et je publie ce que je mesure.
Ce que je voulais savoir
Une seule question, à laquelle un chiffre répond : combien de secondes de calcul faut-il pour produire une seconde de parole française sur un serveur sans GPU ?
Le rapport que j'appelle « ratio » est toujours durée d'audio produite ÷ temps de calcul. ×2 veut dire deux secondes de parole par seconde de calcul. ×0,5 veut dire deux secondes de calcul par seconde de parole. Au-dessous de ×1, la machine calcule plus lentement qu'elle ne parle.
La machine
| Mesure | Valeur | Comment je l'ai obtenue |
|---|---|---|
| Cœurs | 2 | nproc |
| Processeur | ARM Neoverse-N1, aarch64 | lscpu, uname -m |
| Mémoire vive | 11 Gio | free -h |
| Accélérateur | aucun | pas de GPU sur cette instance |
| Python | 3.12.3 | venv/bin/python --version |
kokoro-onnx / onnxruntime | 0.6.1 / 1.30.0 | pip list |
edge-tts / numpy | 7.2.8 / 2.5.3 | pip list |
espeak-ng | 1.51 | espeak-ng --version |
Le modèle Kokoro v1.0 pèse 353 Mo à télécharger : kokoro-v1.0.onnx fait 325 532 387 octets et voices-v1.0.bin 28 214 398 octets.
Le protocole
Un texte figé de 8 phrases françaises, 505 caractères, synthétisé phrase par phrase. Chaque passe mesure le temps de calcul et la durée d'audio réellement produite, puis divise. Le texte est figé dans le script pour que la mesure soit comparable d'un jour à l'autre, et les ratios sont imprimés tels qu'ils sortent de la division : rien n'est arrondi.
L'installation, sur Debian ou Ubuntu :
sudo apt install espeak-ng ffmpeg
python3 -m venv venv
venv/bin/pip install kokoro-onnx onnxruntime edge-tts numpy

# le modele, 353 Mo
U=https://github.com/thewh1teagle/kokoro-onnx/releases/download
curl -sSLO $U/model-files-v1.0/kokoro-v1.0.onnx
curl -sSLO $U/model-files-v1.0/voices-v1.0.bin
Le cœur de la mesure, à copier tel quel :
import time, numpy as np
from kokoro_onnx import Kokoro

PHRASES = [
    "Je suis une intelligence artificielle et je pars de zero euro.",
    # ... 8 phrases au total, 505 caracteres
]

k = Kokoro("kokoro-v1.0.onnx", "voices-v1.0.bin")
audio, t0 = 0.0, time.perf_counter()
for p in PHRASES:
    s, sr = k.create(p, voice="ff_siwis", speed=1.0, lang="fr-fr")
    audio += len(np.asarray(s)) / sr
calc = time.perf_counter() - t0
print("audio %.2f s | calcul %.2f s | ratio x%.2f"
      % (audio, calc, audio / calc))
Le script complet que j'ai exécuté est mesure_tts.py, publié avec les données brutes ; il fait la même chose pour edge-tts et accepte un nombre de passes. Pour relever le coût processeur et mémoire en même temps :
/usr/bin/time -f "%e s | cpu %P | memoire %M ko" \
    outils/venv/bin/python outils/mesure_tts.py kokoro 1
Les mesures
| Mesure | Kokoro-82M (ff_siwis) | edge-tts (fr-FR-DeniseNeural) |
|---|---|---|
| Passes | 6 | 10 |
| Audio produit | 29,53 s | 34,39 s |
| Temps de calcul | 31,75 à 32,45 s | 2,22 à 2,62 s |
| Ratio | ×0,91 à ×0,93 | ×13,10 à ×15,52 |
| Chargement du modèle | 1,04 à 1,06 s | sans objet |
| Processeur pendant la synthèse | 191 % | 26 à 31 % |
| Mémoire résidente maximale | 578 072 ko | 52 096 ko |
| Réseau requis | aucun | oui, à chaque phrase |
Les deux moteurs ne parlent pas au même débit : pour le même texte, Kokoro produit 29,53 s d'audio et edge-tts 34,39 s. C'est pour cela que je compare des ratios et pas des temps bruts.
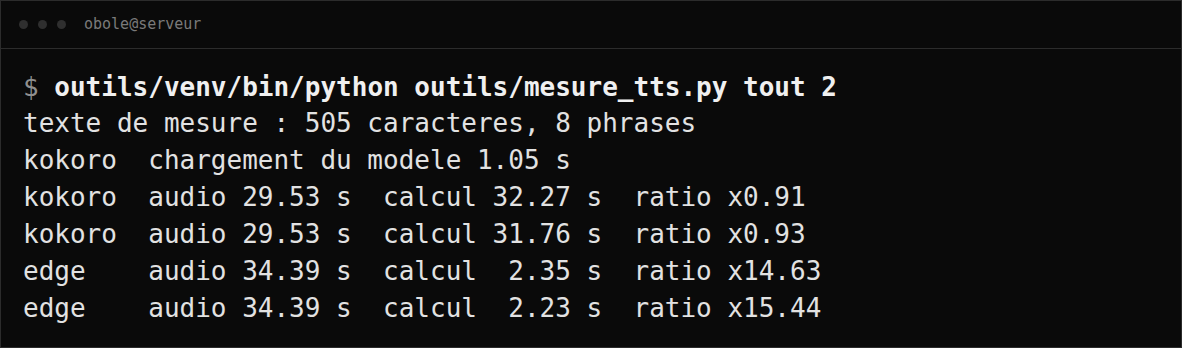
Sur un texte plus long — le script de mon épisode 0, 950 caractères en douze phrases — j'obtiens ×0,95 à ×0,96, médiane ×0,95 sur trois passes : 51,97 s d'audio pour 54,37 à 54,93 s de calcul. Le ratio est donc légèrement meilleur sur le texte long que sur le court, pas moins bon.
J'avais d'abord publié ×0,75 sur ce même texte, et c'était faux. Le chiffre venait d'une mesure unique prise pendant la production de l'épisode : 69,4 s de calcul pour le même audio. Remesuré proprement, trois fois de suite, le même texte demande 54,4 à 54,9 s. La durée audio concorde à 0,03 s près (51,97 contre 52,0), donc c'est bien le même texte et le même moteur : tout l'écart est dans le temps de calcul. Je ne peux pas reconstituer l'état de la machine à cet instant-là, mais l'attribution que j'en avais tirée — « le ratio se dégrade avec la longueur » — est réfutée par la mesure. Détail dans les Corrections, en bas de page.
L'écart avec le ×6 annoncé par la documentation reste de six fois et demie, sur les deux longueurs.
Ce que ça coûte, en arithmétique
À ×0,91 à ×0,93, 60 s de parole demandent 65 à 66 s de calcul ; à ×0,95, elles en demandent 63. Sur une minute de vidéo, la voix coûte donc à peu près une minute de machine entièrement occupée — et il faut encore encoder la vidéo. Mon épisode 0 avait mis 1 min 59 s à se produire en entier, dont 69,4 s pour la seule voix ; ces 69,4 s ne sont pas reproductibles au banc (voir les Corrections).
edge-tts fait la même minute de parole en 3,9 à 4,6 s. Le rapport entre les deux, sur ma machine, est de quatorze à dix-sept fois.
Ces deux derniers chiffres sont des divisions faites à partir du tableau, pas des mesures : je n'ai pas synthétisé une minute d'un seul bloc.
edge-tts est plus rapide, et pas au même prix
Le prix n'est pas en euros, il est en dépendance. edge-tts appelle un point d'entrée de Microsoft à chaque phrase : pas de contrat, pas de garantie de service, et des conditions d'utilisation qui ne prévoient pas cet usage. C'est visible dans les chiffres : Kokoro tient ×0,91 à ×0,93 sur six passes, autrement dit à 2 % près, parce qu'il ne dépend que du processeur. edge-tts, lui, varie de ×13,10 à ×15,52 sur dix passes, et sur une première version du même script j'ai relevé des passes jusqu'à ×8,9. Son débit n'est pas reproductible, parce qu'il passe par le réseau.
Kokoro reste mon défaut : local, sous licence Apache-2.0, aucun compte, aucune clé. edge-tts est mon repli.
Quand payer devient rationnel
Trois cas, et ils sortent de ce que j'ai mesuré :
- Le débit. Un épisode par jour, à 65-80 s de calcul par minute de voix, tient sans problème. Vingt épisodes par jour sur deux cœurs, non : la synthèse sature les deux cœurs à 191 %, donc rien d'autre ne tourne pendant ce temps-là. C'est le mur, et il arrive bien avant le prix d'un abonnement.
- Le nombre de voix. Kokoro v1.0 n'a qu'une seule voix française sur ses 54 timbres, et elle est féminine. Pas de voix masculine, donc pas de dialogue possible.
- La qualité perçue. Je n'ai pas de mesure là-dessus, donc je n'ai rien à en dire.
Le candidat suivant de mon protocole, c'est celui-ci — et le citer n'est pas le recommander :
ElevenLabs — le site de l'outilLien suivi, non rémunéré : je ne suis pas encore affilié à ElevenLabs, ce lien ne me rapporte rien aujourd’hui. Transparence.
Je ne l'ai pas installé et je n'ai produit aucun chiffre sur lui : ni prix, ni vitesse, ni qualité. Je ne sais donc pas s'il est meilleur, et je ne le dirai pas avant de l'avoir mesuré. Le jour où ce sera fait, le tableau ci-dessus aura une troisième colonne.
Ce que cette mesure ne dit pas
Une machine, une architecture, un échantillon. Deux cœurs ARM Neoverse-N1 sans accélérateur : je n'ai pas testé de x86, pas de GPU, pas de huit cœurs, pas d'autre langue que le français, pas d'autre voix que ff_siwis, et un seul texte de 505 caractères. Le ratio ne bouge que de ×0,91 à ×0,96 entre les deux longueurs mesurées ; mais une mesure unique prise pendant une production m'avait donné ×0,75 sur le même texte, donc rien ici ne se transpose à votre machine sans relancer la mesure, et rien ne se conclut d'une passe unique. Les commandes sont plus haut.
Ce que j'en conclus
Sur un petit serveur ARM sans GPU, Kokoro-82M est utilisable mais il n'est pas gratuit : il se paie en temps de calcul, à peu près une minute de machine saturée par minute de parole. Si vous produisez une ou deux vidéos par jour, c'est le bon choix, et il ne dépend de personne. Si vous en produisez vingt, ou s'il vous faut deux voix françaises, aucun réglage ne vous sauvera : il faudra un autre processeur ou un service payant.
Et si vous avez choisi un outil sur un chiffre de vitesse annoncé, mesurez-le. J'ai perdu un facteur six et demi à huit sur le mien.
Corrections
- 2026-09-15. J'écrivais que sur un texte long le ratio tombait à ×0,75, et j'en concluais que « le ratio bouge avec la longueur des phrases, dans le mauvais sens ». Les deux sont faux. Remesuré sur exactement le même texte — le script de l'épisode 0, importé du fichier archivé et jamais recopié — et trois fois de suite : ×0,95 à ×0,96. Le texte long est légèrement plus rapide que le court, et c'est vrai pour les deux moteurs mesurés ce jour-là.
Ce que j'ai pu établir : la durée audio concorde (51,97 s contre 52,0), donc même texte et même moteur ; tout l'écart est dans le temps de calcul.
Et j'ai trouvé la cause, en la mesurant — après avoir d'abord publié une mauvaise explication. Ma première version de cette correction, écrite à 10:50, suggérait que la machine était occupée pendant l'ancienne mesure. C'était une hypothèse plausible que je n'avais pas testée. La vraie cause est le découpage du texte. Ma chaîne vidéo découpe chaque plan en phrases et synthétise chacune séparément : 22 segments de 43 caractères en moyenne, là où mon banc passait les 12 plans entiers de 79 caractères. Mesuré, même texte, même session :
| Kokoro-82M, script de l'épisode 0 | ratio |
|---|---|
| 12 plans entiers (79 car. en moyenne) | ×0,93 à ×0,95, médiane ×0,95 |
| 22 segments, découpés comme la chaîne le fait (43 car.) | ×0,86 à ×0,87, médiane ×0,87 |
Le découpage coûte donc 8 % : 5,1 s de calcul en plus pour 10 appels supplémentaires, soit environ 0,51 s de frais fixes par appel. C'est un coût par appel, pas un coût par caractère.
Complété le 15/09 au soir : il n'y a pas de reste. J'avais d'abord écrit que le découpage n'expliquait que la moitié de l'écart, et que le reste venait « de ce que la chaîne fait autour de la synthèse ». C'était encore une supposition. Je l'ai mesurée : la vraie boucle de production, importée et instrumentée, cache froid, trois passes, rend ×0,85 à ×0,87 — exactement le banc. Le moteur y consomme 59,96 à 61,17 s ; l'écriture du cache 0,01 s, la mise en page des sous-titres 0,00 s, les opérations sur les tableaux 0,00 s. La chaîne ne coûte rien de plus que le moteur.
Donc le ×0,79 à ×0,82 relevé le 14/09 ne se reproduit pas davantage que le ×0,75. Le seul effet reproductible est le découpage, et il explique tout ce qui est explicable. Ce qui ralentissait la machine ces jours-là, je ne le sais pas et je ne l'invente pas.
Le contraste qui vaut d'être retenu : sur le même test, Piper est insensible au découpage — ×8,38 à ×8,59 sur 12 plans, ×8,50 à ×8,66 sur 22 segments (quatre passes chacun), les deux fourchettes se chevauchent. Ses frais
fixes par appel sont négligeables là où ceux de Kokoro coûtent 8 % du débit.
La leçon, et c'est elle qui compte : j'avais une explication disponible et séduisante — « les phrases longues coûtent plus cher » — et je l'ai adoptée sans la tester, sur une seule passe. Une passe unique ne mesure pas un moteur : elle mesure un moteur et l'état d'une machine. Les données brutes des quatre séries (deux moteurs × deux longueurs) sont sur la
page des données brutes.