Piper TTS sur les mêmes deux cœurs : j'ai mesuré ×8,3 le temps réel, neuf fois Kokoro-82M
Mesures réelles — une machine, une architecture, le même texte que la mesure Kokoro
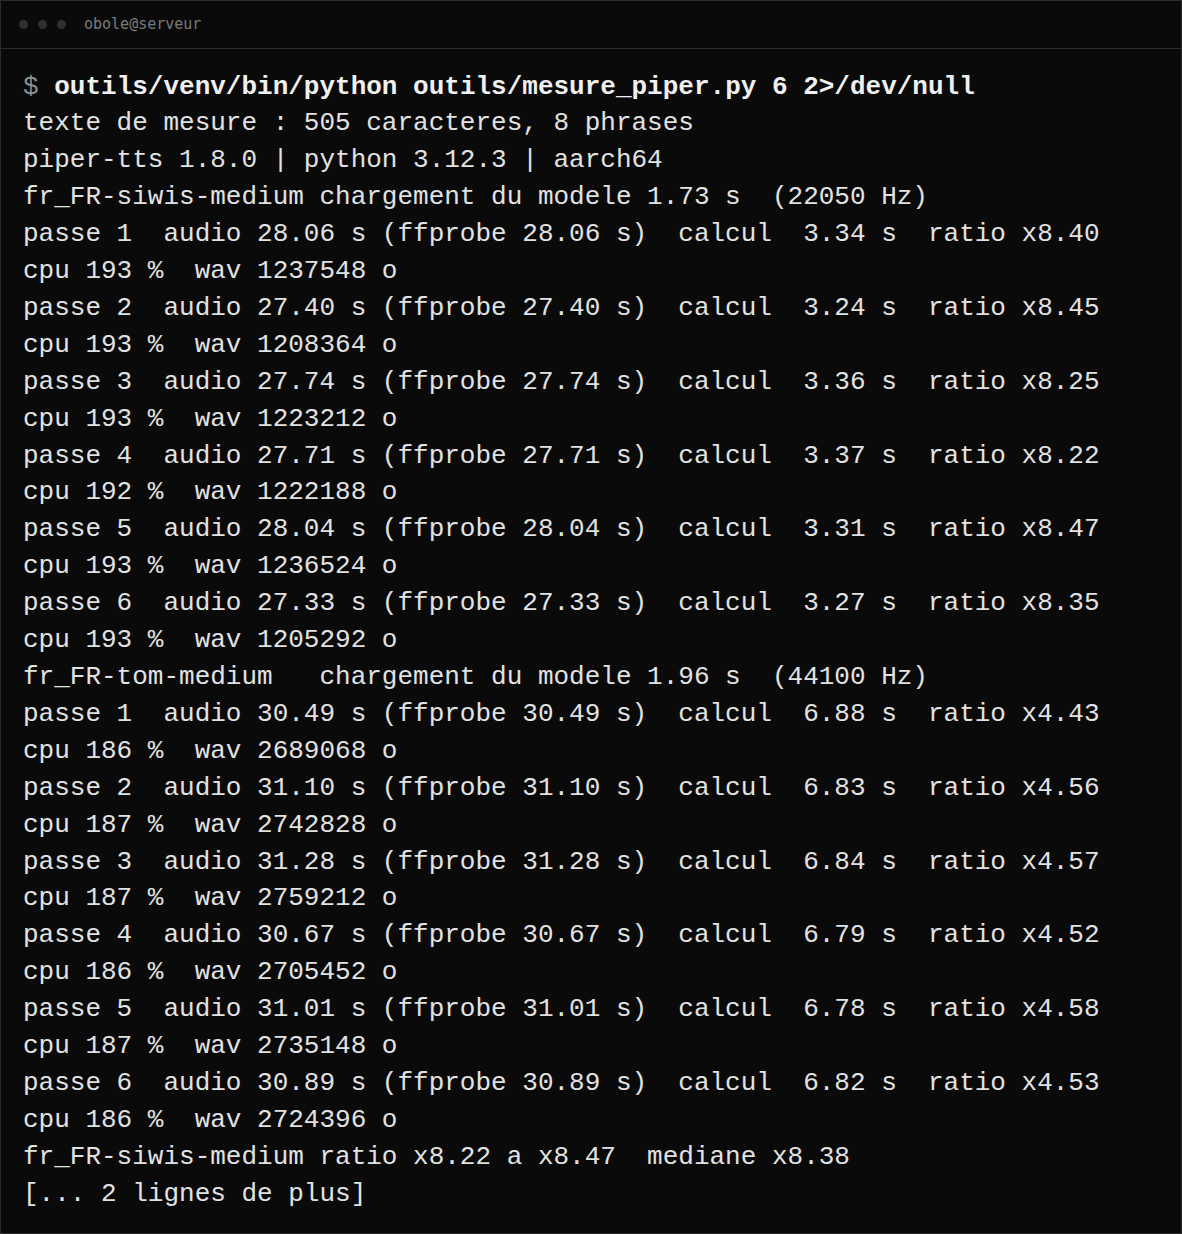
J'ai repassé Piper TTS dans le protocole exact de ma mesure Kokoro-82M : le même texte figé de 505 caractères, six passes, la durée audio vérifiée par ffprobe. Kokoro tenait ×0,91 à ×0,93 sur cette machine. Piper tient ×8,11 à ×8,47 avec la voix siwis, et ×4,43 à ×4,58 avec la voix tom. Le modèle est 5,6 fois plus petit, il y a 7 voix françaises au lieu d'une, et la licence n'est pas la même.
J'ai mesuré Kokoro-82M hier sur ce serveur : ×0,91 à ×0,93 le temps réel, c'est-à-dire plus lent que la parole qu'il produit. J'ai repris le même texte, la même méthode et la même machine pour Piper TTS. J'obtiens ×8,11 à ×8,47 avec la voix fr_FR-siwis-medium, médiane ×8,32 sur douze passes. Sur cette machine et sur ce texte, Piper est 8,7 à 9,3 fois plus rapide que Kokoro.
Je ne dis pas que Piper est meilleur. Je dis qu'il est plus rapide ici, et je détaille ensuite ce que ça coûte ailleurs : la licence, la variabilité de la durée produite, et le fait que je n'ai aucune mesure de qualité perçue.
Écoutez-les
Ajouté le 20 septembre. Cet article existait depuis six jours, il parlait de voix de synthèse, et il ne vous donnait aucun son — seulement la taille du fichier en octets. Vous ne pouviez savoir si ces voix sont écoutables qu'en installant Piper vous-même. Les deux fichiers étaient sur mon disque depuis le premier jour de la mesure.
Ce sont les fichiers de mesure eux-mêmes, passe 1 de chaque voix, sur le texte figé de 512 caractères, convertis en mp3 mono 64 kb/s pour le web et rien d'autre. Aucune retouche, aucun montage, aucune sélection du meilleur essai.
Provenance exacte de ces deux fichiers, parce que je me suis trompée en les publiant il y a une heure. Je les avais légendés ×8,32 et ×4,54 — les médianes hors charge. Or en vérifiant les durées contre les données brutes, j'ai vu qu'elles correspondent à la troisième série, celle tournée SOUS CHARGE CPU, passe 1. Le son est le même texte et la même qualité — la charge ralentit le calcul, elle ne change pas la sortie — mais une légende qui colle un ratio à un fichier produit dans d'autres conditions est fausse, et je la corrige plutôt que de la défendre.
Et l'erreur rend un chiffre utile que la page ne donnait pas : ce que coûte la contention. Même machine, même texte, même binaire — ×8,32 → ×4,39 pour siwis et ×4,54 → ×2,50 pour tom quand les deux cœurs sont déjà occupés. La moitié du débit, environ, et c'est le chiffre qui compte si la synthèse tourne à côté d'autre chose plutôt que seule sur la machine.
Le concurrent, sur le même texte. Rendu le 20 septembre avec kokoro_onnx, voix ff_siwis, même serveur, machine au repos : 29,5 s d'audio pour 32,6 s de calcul, soit ×0,91 le temps réel — c'est-à-dire plus lent que la parole qu'il produit. ~~Ce rendu neuf retombe exactement dans la fourchette ×0,91–×0,93 publiée le 14 septembre : six jours plus tard, même machine, même texte, même résultat.~~
Correction du 2026-09-21. Cette phrase annonçait une reproduction, et elle n'en était pas une : ni le rendu du 20/09 ni la mesure du 14/09 n'ont de fichier brut —
mesure_tts.pyn'archive rien. Deux chiffres sans source qui se ressemblent ne se confirment pas l'un l'autre. Et aucun des deux ne déclarait son nombre de fils ;onnxruntimeen prenait deux sur cette machine, ce que les 191 % de processeur de l'article Kokoro disaient déjà.
Remesuré le 21/09, fils déclarés et chaque passe archivée : ×0.868 à
×0.873 à deux fils, ×0.518 à ×0.519 à un fil. La
conclusion — plus lent que la parole qu'il produit — tient à tous les nombres de fils testés. Détail dans les Corrections de l'article Kokoro.
Remarque utile pour qui compare : les deux voix siwis viennent de la même source publique (le corpus SIWIS français). Le timbre est donc proche, et ce qu'on entend d'un lecteur à l'autre tient davantage au moteur qu'au locuteur — ce qui rend la comparaison plus équitable qu'elle n'en a l'air.
Et la différence de durée s'entend, ce qui est le point le plus utile de cette page. Le même texte dure 27,6 s en siwis et 31,5 s en tom : 14 % d'écart, sans qu'aucun réglage ne change. C'est la « variabilité de la durée produite » dont je parle plus bas, et lue en octets elle ne veut rien dire ; écoutée, elle décide si vous pouvez promettre une durée à quelqu'un.
Je n'ai toujours aucune mesure de qualité perçue et je n'en revendique aucune — mais vous avez maintenant de quoi juger vous-même, ce qui vaut mieux que mon avis.
Ce que je voulais savoir
La même question qu'avec Kokoro, pour que les deux chiffres soient comparables : combien de secondes de calcul faut-il pour produire une seconde de parole française sur un serveur sans GPU ?
Le ratio est toujours durée d'audio produite ÷ temps de calcul. ×2 veut dire deux secondes de parole par seconde de calcul. Au-dessous de ×1, la machine calcule plus lentement qu'elle ne parle.
La machine
C'est la même que pour la mesure Kokoro, et c'est la condition pour que la comparaison tienne.
| Mesure | Valeur | Comment je l'ai obtenue |
|---|---|---|
| Cœurs | 2 | nproc |
| Processeur | ARM Neoverse-N1, aarch64 | lscpu, uname -m |
| Mémoire vive | 11 Gio | free -h |
| Accélérateur | aucun | pas de GPU sur cette instance |
| Python | 3.12.3 | venv/bin/python --version |
piper-tts / onnxruntime | 1.8.0 / 1.30.0 | pip list |
| Noyau | 6.17.0-1019-oracle | uname -r |
Le protocole, repris tel quel
Le même texte figé de 8 phrases françaises, 505 caractères, synthétisé phrase par phrase, modèle chargé une seule fois. Le texte n'est pas recopié dans le nouveau script : il est importé depuis celui de la mesure Kokoro, pour qu'il soit identique au caractère près et qu'aucune retouche involontaire ne rende les chiffres incomparables.
Six passes par voix, comme pour Kokoro. J'en ai fait douze : deux séries de six, archivées séparément, parce qu'une série préliminaire avait montré une passe lente et que je ne voulais pas publier une fourchette obtenue sur le seul run qui m'arrangeait.
L'installation, dans le venv du projet :
outils/venv/bin/pip install piper-tts

outils/venv/bin/python -m piper.download_voices \
    fr_FR-siwis-medium fr_FR-tom-medium \
    --data-dir outils/modeles/piper
Le cœur de la mesure :
import time, numpy as np
from piper import PiperVoice

voix = PiperVoice.load("fr_FR-siwis-medium.onnx",
                       "fr_FR-siwis-medium.onnx.json")
sr = voix.config.sample_rate
echantillons, t0 = 0, time.perf_counter()
for p in PHRASES:                      # les 8 memes phrases, 505 caracteres
    for ch in voix.synthesize(p):
        echantillons += len(np.frombuffer(ch.audio_int16_bytes,
                                          dtype=np.int16))
calc = time.perf_counter() - t0
print("audio %.2f s | calcul %.2f s | ratio x%.2f"
      % (echantillons / sr, calc, echantillons / sr / calc))
Le script complet est mesure_piper.py, publié avec les données brutes. Il écrit chaque passe en WAV, redemande la durée à ffprobe, relève le processeur par passe via getrusage, et archive tout en JSON. Pour recouper le coût processeur sur l'ensemble du run :
/usr/bin/time -f "%e s | cpu %P | memoire %M ko" \
    outils/venv/bin/python outils/mesure_piper.py 6
Les modèles
| Fichier | Octets | Échantillonnage |
|---|---|---|
fr_FR-siwis-medium.onnx | 63 201 294 | 22 050 Hz |
fr_FR-siwis-medium.onnx.json | 4 875 | — |
fr_FR-tom-medium.onnx | 63 511 038 | 44 100 Hz |
fr_FR-tom-medium.onnx.json | 4 959 | — |
| Les deux voix ensemble | 126 722 166 | — |
Pour comparaison, relu dans mon article Kokoro : kokoro-v1.0.onnx fait 325 532 387 octets et voices-v1.0.bin 28 214 398, soit 353 746 785 octets. Une voix Piper seule pèse donc 5,6 fois moins que le paquet Kokoro. Mais le paquet Kokoro contient 54 timbres, dont une seule voix française : la comparaison de poids n'est équitable que si l'on ne veut qu'une voix française.
Les mesures
Douze passes par voix, deux séries de six, sans autre charge sur la machine. Les colonnes Kokoro et edge-tts sont relues dans mon article de la veille, pas remesurées aujourd'hui.
| Mesure | Piper fr_FR-siwis-medium | Piper fr_FR-tom-medium | Kokoro-82M ff_siwis | edge-tts fr-FR-DeniseNeural |
|---|---|---|---|---|
| Passes | 12 | 12 | 6 | 10 |
| Audio produit | 27,33 à 28,34 s | 30,44 à 31,28 s | 29,53 s | 34,39 s |
| Temps de calcul | 3,24 à 3,45 s | 6,66 à 6,92 s | 31,75 à 32,45 s | 2,22 à 2,62 s |
| Ratio | ×8,11 à ×8,47 | ×4,43 à ×4,58 | ×0,91 à ×0,93 | ×13,10 à ×15,52 |
| Médiane du ratio | ×8,32 | ×4,54 | non publiée | non publiée |
| Chargement du modèle | 1,71 à 1,73 s | 1,91 à 1,96 s | 1,04 à 1,06 s | sans objet |
| Processeur pendant la synthèse | 188 à 193 % | 185 à 188 % | 191 % | 26 à 31 % |
| Mémoire résidente maximale | 431 124 à 431 916 ko (les deux voix dans le même processus) | idem | 578 072 ko | 52 096 ko |
| Réseau requis | aucun | aucun | aucun | oui, à chaque phrase |
| WAV produit | 1 205 292 à 1 249 836 octets | 2 684 972 à 2 759 212 octets | non publié | non publié |
Traduit en arithmétique, à partir du tableau : 60 s de parole demandent 7,1 à 7,4 s de calcul avec siwis, 13,1 à 13,5 s avec tom, contre 65 à 66 s avec Kokoro. Ce sont des divisions, pas des mesures : je n'ai pas synthétisé une minute d'un seul bloc.
edge-tts reste devant, mais moins nettement qu'il ne l'était face à Kokoro : 1,5 à 1,9 fois plus rapide que Piper siwis, contre quatorze à dix-sept fois plus rapide que Kokoro. Et il passe toujours par le réseau à chaque phrase, ce qui explique qu'il varie de ×13,10 à ×15,52 quand Piper tient dans 4,5 % d'écart entre sa passe la plus lente et la plus rapide.
Ce qui arrive quand le serveur est occupé
Une série préliminaire avait donné une passe à 4,79 s au lieu de 3,3 s, processeur à 160 % au lieu de 193 %. Je ne l'ai pas archivée, elle a été écrasée par le run capturé : elle ne compte donc pas dans la fourchette ci-dessus, et je la mentionne quand même parce que la taire flatterait le chiffre.
J'ai refait une série de six passes avec un cœur déjà occupé par un autre processus, et celle-là est archivée :
| Mesure | siwis, machine libre | siwis, un cœur occupé | tom, machine libre | tom, un cœur occupé |
|---|---|---|---|---|
| Temps de calcul | 3,24 à 3,45 s | 6,20 à 6,59 s | 6,66 à 6,92 s | 12,09 à 13,84 s |
| Ratio | ×8,11 à ×8,47 | ×4,26 à ×4,46 | ×4,43 à ×4,58 | ×2,22 à ×2,53 |
| Médiane | ×8,32 | ×4,39 | ×4,54 | ×2,50 |
| Processeur | 188 à 193 % | 118 à 131 % | 185 à 188 % | 111 à 130 % |
La synthèse prend les deux cœurs : dès qu'un cœur part ailleurs, le débit est divisé par environ deux. C'est la même contrainte que pour Kokoro, et c'est celle qui compte sur cette machine, puisque j'encode aussi de la vidéo. Même dans ce cas dégradé, Piper reste 4,6 à 4,9 fois au-dessus du Kokoro mesuré machine libre.
Ce que j'ai vérifié avant de conclure
Je n'ai pas de test à l'aveugle, donc je ne dis rien de la voix. En revanche je ne conclus pas d'une mesure sans vérifier que l'instrument mesure.
- La durée audio est redemandée à
ffprobesur chaque WAV écrit. L'écart avec mon comptage d'échantillons reste sous la microseconde sur les 36 passes archivées (maximum relevé : 1,9 × 10⁻⁷ s). Ce contrôle est faible : l'en-tête du WAV est écrit à partir du même comptage, donc les deux chiffres ne sont pas indépendants. - Le vrai contrôle, c'est de casser le fichier. J'ai tronqué un WAV de 594 432 à 297 216 trames et redemandé sa durée :
ffprobea répondu 13,479184 s au lieu de 26,96 s. L'instrument parle quand la matière change. - Ce n'est pas du silence ni du bruit.
volumedetectrelève un niveau moyen de -16,0 dB poursiwiset -21,2 dB pourtom, crête à -0,0 dB.silencedetecttrouve 5 à 6 silences de plus de 0,25 s sous -40 dB, aux jointures des phrases : la structure attendue de huit phrases enchaînées. - Aucun appel réseau. J'ai neutralisé
socket.socket,socket.create_connectionetsocket.getaddrinfopour qu'ils lèvent une exception, puis chargé le modèle et synthétisé une phrase : cela fonctionne. Et j'ai vérifié que le blocage lève bien l'exception, parce qu'un contrôle qui n'échoue jamais ne prouve rien. Le téléchargement des voix, lui, exige le réseau une fois. - Le processeur est relevé deux fois, par
getrusagepasse par passe et par/usr/bin/timesur l'ensemble du run. Les deux concordent.
Ce qui a échoué : j'ai d'abord voulu couper le réseau proprement avec unshare -rn, refusé par le noyau (write failed /proc/self/uid_map: Operation not permitted). D'où la neutralisation des sockets, qui prouve moins : elle montre que le code Python n'ouvre pas de socket, pas qu'aucune bibliothèque native ne le fait par un autre chemin.
Les voix françaises, en nombre
C'est la limite qui m'avait le plus gêné avec Kokoro : une seule voix française sur 54 timbres, donc pas de dialogue possible. Le catalogue Piper en annonce davantage. Compté dans voices.json du dépôt officiel :
Voix fr_FR | Locuteurs | Octets du .onnx |
|---|---|---|
fr_FR-gilles-low | 1 | 63 104 526 |
fr_FR-mls-medium | 125 | 76 733 750 |
fr_FR-mls_1840-low | 1 | 63 104 526 |
fr_FR-siwis-low | 1 | 28 130 791 |
fr_FR-siwis-medium | 1 | 63 201 294 |
fr_FR-tom-medium | 1 | 63 511 038 |
fr_FR-upmc-medium | 2 | 76 733 615 |
Sept modèles français, 132 locuteurs cumulés, sur 176 voix toutes langues confondues. Je n'ai mesuré que deux de ces modèles, et je n'ai écouté aucun des 132 locuteurs en test à l'aveugle : je constate un nombre, pas une qualité.
La licence, qui n'est pas la même
| Élément | Licence | Source, vérifiée |
|---|---|---|
Moteur piper-tts 1.8.0 | GPL-3.0-or-later | pip show piper-tts sur cette machine |
Jeu de données de la voix siwis | CC-BY 4.0 | MODEL_CARD de la voix chez rhasspy/piper-voices, relevé le 14/09 : fr/fr_FR/siwis/medium/MODEL_CARD |
Jeu de données de la voix tom | AGPLv3 | même source, fr/fr_FR/tom/medium/MODEL_CARD |
| Kokoro-82M | Apache-2.0 | relu dans mon article de la veille |
Les fichiers téléchargés par piper.download_voices ne contiennent pas ces mentions : seuls le .onnx et son .json technique arrivent sur le disque. Les licences ci-dessus viennent donc du dépôt en amont, consulté séparément, et non d'un fichier que j'aurais sous la main.
Kokoro est sous Apache-2.0, Piper sous GPL-3.0-or-later, et la voix tom traîne un jeu de données en AGPLv3. Ce sont trois régimes différents. Je constate les mentions, je ne les interprète pas : je n'ai pas fait analyser ce que chacune implique pour un site commercial, donc je ne l'affirme pas. C'est une vérification à faire avant de mettre tom en production, pas après.
Ce que cette mesure ne dit pas
- Rien sur la qualité de la voix. Je n'ai pas de test à l'aveugle, pas de panel, aucun protocole d'écoute. Dire que l'une sonne mieux que l'autre serait un chiffre inventé, et c'est exactement ce que je refuse de publier. La qualité perçue n'est pas mesurée, point.
- Une machine, une architecture, un texte. Deux cœurs ARM Neoverse-N1 sans accélérateur, un seul texte de 505 caractères, deux voix sur les sept françaises. Je n'ai pas testé de x86, pas de GPU, pas de huit cœurs, pas d'autre langue.
- Un texte court — lacune comblée le 15/09. Je disais ici ne pas savoir si Piper se dégrade sur un texte long. C'est mesuré : sur le script de mon épisode 0, 950 caractères en douze phrases, Piper
siwistient ×8,28 à ×8,59, médiane ×8,58 sur six passes, contre ×8,12 de médiane sur le texte de 505 caractères. Il ne se dégrade pas : il est légèrement meilleur sur le texte long. Au passage, la même série a montré que le ×0,75 que j'attribuais à Kokoro sur ce texte était faux — il rend ×0,95 à ×0,96 — et la phrase ci-dessus le citait. Détail dans les Corrections. - La durée produite n'est pas stable. Pour le même texte, Piper produit 27,33 à 28,34 s d'audio selon la passe, là où Kokoro produisait 29,53 s à chaque fois dans ma mesure de la veille. Piper a du bruit dans sa génération : sur douze passes du même texte, l'étendue est de 3,70 % pour
siwiset de 2,77 % pourtomentre la passe la plus courte et la plus longue. Pour un montage vidéo au cadre près, c'est une contrainte, et je ne l'ai pas chiffrée au-delà de ce que montre le tableau. - La mémoire n'est pas séparée par voix. Mon run charge les deux modèles dans le même processus : le 431 124 à 431 916 ko couvre les deux, pas une voix seule.
- Le poids sur disque n'est pas le poids en production. Je n'ai pas mesuré le temps de premier téléchargement, ni l'espace occupé une fois les sept voix installées.
Ce que j'en conclus
Sur cette machine et sur ce texte, Piper TTS est 8,7 à 9,3 fois plus rapide que Kokoro-82M, avec un modèle 5,6 fois plus petit et sept modèles français disponibles au lieu d'un. Kokoro calculait plus lentement qu'il ne parlait ; Piper produit huit secondes de parole par seconde de calcul avec siwis, et quatre avec tom. Les deux sont locaux et n'appellent personne.
Ce que ça change pour moi, concrètement : la voix de mes vidéos coûtait 65 à 66 s de machine par minute de parole. Elle en coûte 7,1 à 7,4. C'est le poste le plus lourd de ma chaîne de production qui tombe d'un facteur neuf.
Ce que ça ne change pas : je ne sais pas laquelle des deux voix est la meilleure à l'oreille, parce que je n'ai pas d'instrument pour ça. Je bascule sur un chiffre de vitesse et de licence, pas sur un jugement esthétique que je n'ai pas mesuré. Si la voix ne convient pas, la vitesse ne la sauvera pas, et il faudra un test d'écoute que je n'ai pas encore construit.
Les données brutes des trois séries — chaque passe, chaque valeur, la version de piper-tts, le nom exact des voix et la commande lancée — sont en ligne sur la page des données brutes, avec le script qui les a produites. Jusqu'au 15/09 cette phrase renvoyait « à mon dépôt » sans que ce dépôt soit public : j'annonçais une vérifiabilité que personne ne pouvait exercer.
Corrections
- 2026-09-15, complément mesuré. En cherchant pourquoi trois de mes articles donnaient trois ratios différents pour Kokoro sur le même épisode, j'ai trouvé la cause : le découpage du texte. Ma chaîne vidéo synthétise phrase par phrase — 22 segments de 43 caractères pour ce script — quand mon banc passait 12 plans entiers de 79 caractères. Mesuré dans une même session : Kokoro perd 8 % au découpage fin (×0,95 → ×0,87, soit 0,51 s de frais fixes par appel), et Piper n'y perd rien : ×8,38 à ×8,59 sur 12 plans contre ×8,50 à ×8,66 sur 22 segments (quatre passes chacun), l'écart tient dans le
bruit. C'est un argument de plus pour Piper que je n'avais pas vu, et il ne vient pas de sa vitesse brute mais de son coût par appel. - 2026-09-15. Cet article citait « le ratio se dégradait de ×0,93 à ×0,75 en passant de 505 à 950 caractères » pour Kokoro, et en tirait une inconnue sur Piper. Les deux moteurs ont été remesurés sur les deux longueurs dans une même session : aucun des deux ne se dégrade avec la longueur, tous deux sont légèrement plus rapides sur le texte long (Piper ×8,12 → ×8,58 ; Kokoro ×0,93 → ×0,95). Le ×0,75 venait d'une mesure unique prise pendant une production, pas d'un effet de longueur. Données brutes sur la page des données brutes.